复盘推理芯片这几年的公开动态,最容易被忽略的一点是:真正决定产品落地节奏的,往往不是单点算力数字,而是架构分工、封装选择、工具链适配与量产验证这四条主线能否同步推进。看球网行业资讯栏目持续整理公开来源,本文尝试用复盘视角把这四条线拆开,帮助读者在碎片信息里建立可对照的时间线。
主线一:架构分工从通用走向场景化
结论先行:推理芯片的架构讨论已从“堆多少算力”转向“算力怎么分配”。早期公开资料多强调峰值指标,近年的架构发布则更常提及矩阵单元与向量单元的配比、片上缓存层级设计,以及面向不同批量规模的调度策略。
看球网在梳理架构发布信息时注意到一个共性:面向数据中心批量推理的方案更强调吞吐与显存容量,面向端侧与边缘的方案则把能效比和内存占用放在更前的位置。这种分工并非简单的产品分级,而是架构层面取舍的结果。读者在对比不同架构发布时,可以重点看三个公开维度:单元配比说明、缓存层级描述、以及官方给出的典型工作负载类型。
- 数据中心方向:吞吐优先,显存容量与带宽描述更详细。
- 边缘方向:能效与内存占用优先,常附典型功耗区间。
- 端侧方向:工具链与模型适配说明占比明显提升。
主线二:封装选择成为架构之外的第二个变量
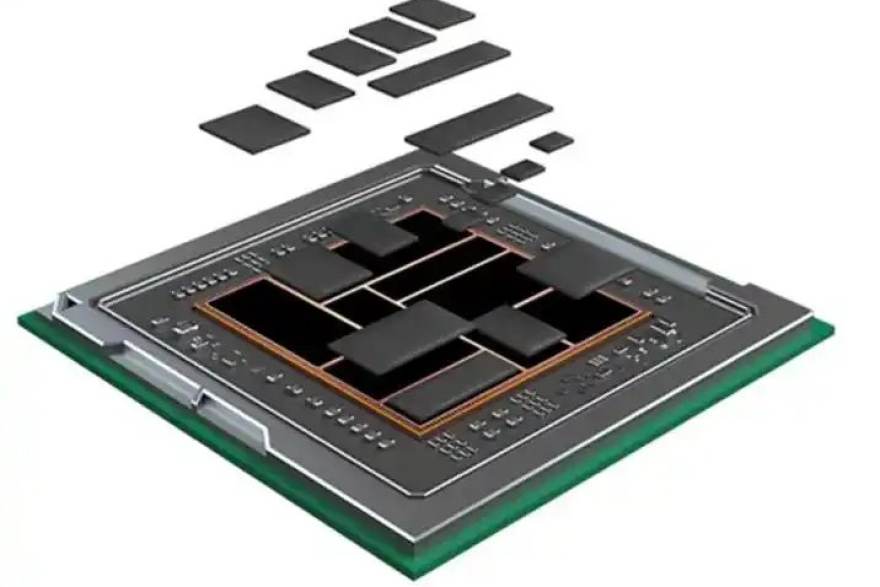
封装讨论的热度上升,本质是推理芯片的性能瓶颈从计算侧向数据搬运侧转移。公开的封装进展信息里,2.5D 中介层方案与 Chiplet 拆分思路被反复提及,但两者的适用场景并不相同。
看球网在整理封装相关公开资料时发现,讨论焦点集中在三点:一是高带宽存储与计算 die 的互连方式,二是封装尺寸对散热和供电的影响,三是良率与成本在公开表述中的谨慎处理。需要提醒的是,封装环节的良率、成本等数据多数未公开,读者遇到具体数字时应优先核对来源是否为厂商公开规格书或行业组织白皮书。复盘这条主线时,更稳妥的做法是记录“某类封装被某类产品采用”的公开事实,而不是追逐未经验证的量化结论。
主线三:工具链与运行时决定落地效率
架构和封装解决的是“能不能算”,工具链解决的是“好不好用”。复盘公开动态可以看到,编译器成熟度、算子覆盖范围、模型转换流程的完整度,正在成为推理芯片对外披露的重点内容。
看球网观察到,生态协作类公开信息里,运行时对动态形状的支持、量化流程的自动化程度、以及对主流模型结构的适配速度,是三条被反复验证的观察指标。对读者而言,判断一款推理芯片的落地效率,不妨从公开文档的更新频率和示例完整度入手,这比单看架构参数更接近真实使用体验。多端同步的资讯整理方式,也让看球网能够把分散的工具链更新按时间顺序归拢,方便读者对照。
主线四:量产验证是复盘时间线的锚点
公开信息里最容易被高估的是发布,最容易被低估的是验证。推理芯片从架构发布到规模落地,中间要经过样片验证、系统集成、稳定性测试等多个环节,而这些环节的公开信息通常零散且滞后。
看球网建议读者在建立时间线时,把“架构发布”“封装方案公开”“工具链版本更新”“终端产品公开采用”四类事件分开记录,避免把发布节点误当量产节点。复盘的价值不在于预测,而在于把可核验的公开事实按顺序排好,让每一次新动态都能找到它在时间线上的位置。这也是看球网行业资讯栏目持续编辑校对的出发点:不追热点结论,只做可回溯的整理。
封装那条线确实容易被带偏,很多文章一上来就谈良率,其实公开资料里根本没这些数。
工具链更新频率这个观察角度挺实用,比看参数表靠谱,至少能看出厂商是不是在认真维护。
四条主线分开记时间线的方法我准备试试,之前看资讯总是东一榔头西一棒子。
端侧和边缘的取舍说得比较克制,没有硬吹某一路线,这点好评。
运行时对动态形状的支持确实是落地时的痛点,希望后面能多整理这类公开文档的变化。
在多端上刷到这篇,排版清楚,适合通勤时候看,希望能保持这种复盘风格。